简单的Python成绩系统
从 0 到 1 完成 JSON 学生成绩管理系统
用这份笔记记录解题思路:先读懂要求,再设计数据和流程,接着逐个实现函数,最后组装完整程序并验证。
学习重点是 JSON、pathlib、文件读写、异常处理、数据校验和函数拆分。
一、题目要求
1.1 概要
编写一个命令行学生成绩管理系统,用列表和字典管理学生,并用 students.json 保存数据。
| 菜单 | 要实现的功能 | 判断功能完成的标准 |
|---|---|---|
| 1 | 查看所有学生 | 按顺序显示姓名和成绩;空列表时提示“暂无学生数据” |
| 2 | 添加学生 | 姓名非空、不重名;成绩为 0~100 的数字;全部通过后才添加 |
| 3 | 查询学生 | 按姓名精确匹配,显示第一个匹配结果;找不到时提示“学生不存在” |
| 4 | 删除学生 | 删除第一个姓名匹配的学生;找不到时不改变列表 |
| 5 | 查看平均成绩 | 非空时计算平均成绩并显示两位小数;空列表时不进行除法 |
| 6 | 保存数据 | 将内存里的完整学生列表写入 JSON 文件,并提示结果 |
| 7 | 退出程序 | 输出“程序结束”,结束菜单循环;不自动保存 |
| 其他输入 | 处理无效菜单项 | 提示输入 1~7,再次显示菜单 |
1.2 处理启动时的文件问题
除了菜单功能,还需要考虑数据从哪里来:
- 文件存在,而且 JSON 和学生数据都合法:使用文件中的数据。
- 文件不存在:提示原因,使用初始学生数据。
- JSON 格式错误、数据结构错误或发生已处理的读取错误:提示原因,使用初始学生数据。
- 使用初始数据时:返回独立副本,避免后续操作修改初始模板。
把学生记录的有效条件写清楚:
- 学生数据的最外层是列表。
- 每位学生是字典。
- 姓名是去掉首尾空白后仍非空的字符串。
- 成绩的确切类型是
int或float,不能是布尔值。 - 成绩范围包含 0 和 100。
把“加载检查”和“添加检查”分开理解:添加时去掉姓名首尾空白并检查重名;加载时只检查姓名是否有效,保留原字符串,也不检查重名。
1.3 先明确保存规则
采用手动保存:
1 | |
这意味着“添加成功”只表示内存修改成功。如果希望下次运行还能看到修改,就需要在退出前选择保存。
两个细节:
- 使用初始数据,不会立即创建文件;选择保存时才尝试写入。
- 文件损坏后回退到初始数据,不会自动修复文件;随后保存会用当前列表覆盖原内容。
二、设计数据结构和文件表示
2.1 为什么选择“列表中放字典”
需要保存多位学生,也需要同时记录每个人的姓名和成绩,所以用:
1 | |
| 层级 | 类型 | 如何理解 |
|---|---|---|
students |
list |
所有学生的集合,保留显示顺序 |
students[0] |
dict |
一位学生的记录 |
student["name"] |
str |
姓名 |
student["score"] |
int 或 float |
成绩 |
这样的结构方便用 for 遍历,用 append() 添加,用 remove() 删除,也方便直接保存为 JSON。
2.2 区分内存数据和文件数据
不要把 Python 对象和 JSON 文本混为一谈:
1 | |
需要使用的两个函数处理文件对象;带 s 的另外两个函数处理字符串:
| 函数 | 传入什么 | 得到什么 |
|---|---|---|
json.load(file) |
包含 JSON 的文件对象 | 解析后的 Python 对象 |
json.dump(data, file) |
Python 对象和可写文件对象 | 写入 JSON 文本,返回 None |
json.loads(text) |
JSON 字符串 | 解析后的 Python 对象 |
json.dumps(data) |
Python 对象 | JSON 字符串 |
用“带 s 处理字符串”来记忆。需要查阅时,参考 Python 官方 JSON 文档。
2.3 设计 students.json 的内容
初始学生数据保存为文件后,应当是这样的 JSON:
1 | |
记住 JSON 的书写规则:
- 键和字符串使用双引号,数字不加引号。
- 最后一项后面不加逗号,不写 Python 注释。
- JSON 的
true、false、null对应 Python 的True、False、None。 "80"是字符串,80才是数字。
还需要注意:JSON 能解析,不代表它满足学生数据要求。 例如 {} 和 [{"name": "Tom", "score": "80"}] 都能解析,但不符合的数据规则。
三、先设计流程,再开始实现
3.1 完成这题的开发路线
按下面的顺序从空白脚本走到完整程序。这里记录的是写出程序的过程;运行时的流程放在下一小节。
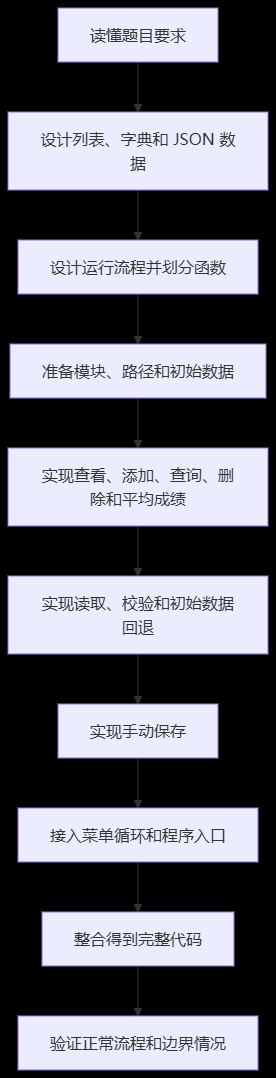
把每一步要完成的东西列出来,写代码时就能逐项推进:
| 阶段 | 要解决的问题 | 对应内容 |
|---|---|---|
| 理解要求 | 需要哪些功能和规则? | 第一节 |
| 设计数据 | 学生用什么结构保存?文件是什么格式? | 第二节 |
| 设计流程 | 程序先做什么,功能怎样拆分? | 第三节 |
| 准备脚本 | 模块、路径和初始数据怎样定义? | 第四节 |
| 实现内存功能 | 怎样查看、添加、查询、删除和求平均? | 第五节 |
| 实现读取 | 怎样加载、校验和回退? | 第六节 |
| 实现保存 | 怎样把当前数据写入文件? | 第七节 |
| 组装程序 | 怎样让菜单调用各个函数? | 第八节 |
| 完成代码 | 怎样合并成可以运行的脚本? | 第九节 |
| 验证与复习 | 正常输入和边界情况是否符合要求? | 第十节起 |
3.2 设计程序运行时的顺序
1 | |
只在进入菜单前加载一次数据。之后的操作共用同一个 students 列表,不在每轮菜单中重新读取文件。
3.3 划分函数职责
| 函数 | 交给它的任务 | 返回值 | 是否改变数据 |
|---|---|---|---|
load_students() |
读取 JSON、校验,失败时返回初始副本 | 学生列表 | 不写文件 |
show_students(students) |
显示全部学生 | None |
不修改 |
add_student(students) |
接收输入,验证后添加 | None |
成功时修改列表 |
find_student(students) |
查询并打印第一个匹配结果 | None |
不修改 |
delete_student(students) |
删除第一个匹配结果 | None |
成功时修改列表 |
show_average(students) |
计算并显示平均成绩 | None |
不修改 |
save_students(students) |
将列表覆盖保存为 JSON | None |
写文件 |
main_menu() |
加载数据、循环菜单、调用功能 | None |
调度其他函数 |
让每个函数处理一件事,菜单只负责组织调用。这样遇到错误时,能先定位是输入校验、列表操作还是文件操作出了问题。
四、准备运行环境、模块和初始数据
4.1 先准备一个 Python 脚本
把程序保存为 student_manager.py,并按下面的方式组织文件:
1 | |
最终完成后,在终端中运行:
1 | |
用单独的练习目录测试不同文件内容,便于保留学习数据。
4.2 导入模块,定义路径和初始数据
先写好脚本顶部的内容:
1 | |
| 内容 | 使用它的原因 |
|---|---|
import json |
后续读写 JSON |
from pathlib import Path |
用路径对象表示数据文件位置 |
STUDENTS_FILE |
让读取和保存使用同一个路径 |
INITIAL_STUDENTS |
文件无法正常使用时,提供四位初始学生 |
在接下来的各节逐步加入函数;这些片段属于同一个脚本,第九节给出可直接运行的完整版本。
4.3 理解 pathlib 这行代码
1 | |
把它拆开理解:
__file__提供当前模块的文件路径。Path(__file__)把它表示为路径对象。with_name("students.json")保留父目录,把最后的文件名部分替换为students.json。
例如:
1 | |
这一步只是得到新路径,不会创建文件,也不会重命名脚本。Path() 本身也不会把任意相对路径自动变成绝对路径。方法说明见 Python 官方 pathlib 文档。
采用常规 .py 脚本运行方式。交互解释器或部分 Notebook 没有 __file__,直接执行这行路径定义可能出现 NameError。
4.4 先准备临时测试数据
在还没写好文件读取函数时,可以用初始数据的副本试运行已经完成的功能:
1 | |
这只是分步学习时的测试准备;最终程序会由 main_menu() 调用 load_students() 得到列表。
五、先完成内存中的学生管理功能
5.1 先实现查看所有学生
的思路很直接:列表为空就提示并结束函数;有学生就依次打印。
1 | |
在这里理解两个写法:
if not students:空列表的布尔值为假。- 单独的
return:结束当前函数,返回None。
用 :g 显示成绩。80.0 通常显示为 80,但这个格式通常默认使用 6 位有效数字,也可能舍入或使用科学计数法。
1 | |
把“显示结果”和“实际成绩”分开理解:格式化不会把列表中的 99.999999 改成 100。规则可以查阅 Python 官方格式说明。
这一小步的检查: 四位初始学生能按顺序显示;传入 [] 时只显示“暂无学生数据”。
5.2 实现按姓名查询
先处理输入的首尾空白,再遍历学生;找到第一个相同姓名后,打印成绩并结束函数。
1 | |
使用 == 精确比较姓名,因此 Tom 与 tom 不相同。return 让查找在第一次匹配后结束;只有整个循环都没找到,才会输出“学生不存在”。
这一小步的检查: 查询 Tom 显示 80 分;查询 Unknown 提示不存在。
5.3 实现平均成绩
先判断空列表,保证分母不是零;再求总分,除以人数。
1 | |
逐行理解计算过程:
| 代码 | 如何理解 |
|---|---|
student["score"] for student in students |
生成器表达式,依次提供每位学生的成绩 |
sum(...) |
求成绩总和 |
len(students) |
统计人数 |
total_score / len(students) |
总分除以人数 |
{average:.2f} |
固定显示小数点后两位 |
初始四人的平均成绩为:
1 | |
这一小步的检查: 初始数据得到 85.00 分;空列表提示后直接返回,不执行除法。
5.4 实现添加学生:先验证,再修改列表
添加会修改数据,所以先把步骤想清楚:
1 | |
按这个流程,写出添加函数:
1 | |
把校验分为三个阶段:
- 姓名非空。
strip()后仍为空,就提前返回。 - 姓名不重复。 逐个比较已有姓名,匹配就提前返回。
- 成绩有效。 先转换为浮点数,再检查闭区间 0~100。
把添加操作放进 else,因为只有转换和范围检查全部成功,才应该改变列表。
理解 try / except / else 与 raise
| 写法 | 在添加函数中的意义 |
|---|---|
try |
尝试转换成绩,并执行范围检查 |
float("abc") |
转换失败,自动抛出 ValueError |
raise ValueError(...) |
转换成功但范围不合法时,主动抛出异常 |
except ValueError |
输出固定错误提示,保持列表不变 |
else |
try 正常完成后,追加学生字典 |
raise 中的详细消息没有在这里直接打印,因为 except 使用的是统一提示。else 自身发生的异常也不由前面的 except 捕获。语义可查阅 Python 官方异常教程。
还记住:这个函数没有内部重输循环。成绩错误后会结束本次添加,回到菜单;需要再次选择添加才能重试。
这一小步的检查:
| 输入的内容 | 应当看到的结果 |
|---|---|
| 姓名为空或全为空格 | 提示姓名不能为空,不再询问成绩 |
姓名为 Tom |
提示姓名重复,不再询问成绩 |
新姓名,成绩为 0、100、85.5 |
添加成功 |
新姓名,成绩为 abc、-1、101 |
提示输入错误,列表不变 |
新姓名,成绩为 nan、inf、-inf、1e309 |
转换后仍不能通过范围检查,列表不变 |
通过 float() 得到浮点成绩,所以输入 88 后保存到内存的是 88.0。-0.0 也满足范围规则。
5.5 实现删除学生
沿用查询时的姓名匹配方式;找到后删除,并立即结束函数。
1 | |
注意到这里是在遍历列表时调用 remove()。这版代码删除第一条匹配记录后马上 return,不会继续遍历已改变的列表。
如果以后要删除所有匹配记录,就需要重新设计遍历方式,避免跳过元素。
这一小步的检查: 删除 Tom 后人数减少一位;删除不存在的姓名时,列表保持原样。
5.6 确认这些函数如何影响同一个列表
函数参数接收的是列表对象的引用。因此,在添加函数中调用 append(),或在删除函数中调用 remove(),之后查看同一个列表就能看到变化。
| 操作 | 是否改变列表 | 是否写入文件 |
|---|---|---|
| 查看、查询、平均成绩 | 否 | 否 |
| 成功添加 | 是 | 否 |
| 成功删除 | 是 | 否 |
到这里,已经完成内存中的功能;接下来让它们可以从文件恢复数据,并由手动保存。
六、实现读取、数据校验和初始数据回退
6.1 先把读取流程分成三层
需要同时处理“文件能否读取”“JSON 能否解析”“学生数据能否使用”。
1 | |
采用整体校验:一条记录不合法,就不使用整份文件数据。这样菜单收到的列表始终符合这版数据规则。
6.2 写出 load_students()
1 | |
从正常路径开始理解:
- 使用
"r"和 UTF-8 编码打开数据文件。 - 调用
json.load(file)得到 Python 对象。 - 校验列表和每位学生。
- 全部合法时返回读取到的列表。
- 发生已处理的异常后,走到函数末尾,返回初始副本。
6.3 理解 with open 和读取模式
1 | |
"r" 表示读取;文件不存在时会抛出 FileNotFoundError。with 在退出代码块时关闭文件,包括代码块中出现异常的情况,所以不用另外调用 file.close()。
把资源关闭和异常处理分开理解:with 负责关闭文件,外面的 except 决定出现错误后怎样处理。
6.4 先校验结构,再校验字段
第一层确认最外面是列表:
1 | |
第二层确认每条记录有效:
| 检查顺序 | 排除的情况 | 例子 |
|---|---|---|
| 1 | 不是字典 | 列表中的 "Tom"、80、null |
| 2 | 姓名缺失或不是字符串 | 缺少 name,或姓名为数字 |
| 3 | 姓名去掉首尾空白后为空 | ""、" " |
| 4 | 成绩缺失或类型不是确切的整数、浮点数 | "80"、true、null |
| 5 | 成绩不在闭区间 0~100 | -1、101、非有限成绩 |
允许合法空列表 [],也允许记录带额外字段。额外字段会随字典保留,但不会在这版菜单中显示。
为什么先用 get(),再用方括号
1 | |
先用 get() 判断字段类型,确认它存在且合法后,再用方括号访问。
为什么保持 or 的检查顺序
or 从左到右求值,遇到真值就不再计算后面的条件。这里的每个条件都在判断“是否不合格”,所以前面发现问题后就停止。
这样能保证:
- 学生不是字典时,不会再调用
.get()。 - 姓名不存在或不是字符串时,不会再执行
.strip()。 - 成绩不存在或类型不正确时,不会再做数字范围比较。
不随意重排这些检查,因为顺序本身就是保护措施。语义见 Python 官方布尔运算说明。
为什么用确切类型排除 bool
1 | |
Python 的 bool 是 int 的子类:
1 | |
因此,如果直接改用 isinstance(score, (int, float)),布尔值也会通过类型检查。原代码的确切类型检查会拒绝 JSON 中的 true 和 false 成绩。说明见 Python 官方布尔类型文档。
如何理解范围检查和特殊浮点数
1 | |
链式比较要求成绩同时满足两个边界条件。NaN、正无穷和负无穷都不符合这个范围。
Python 默认 JSON 解码器可以读入 NaN、Infinity 等扩展值,但仍会在成绩校验阶段拒绝它们。说明见 JSON 解码器文档。
6.5 安排异常分支的顺序
| 异常 | 遇到的典型情况 | 怎样处理 |
|---|---|---|
FileNotFoundError |
文件不存在 | 提示后返回初始副本 |
json.JSONDecodeError |
空文件、JSON 损坏或语法错误 | 提示 JSON 格式错误后回退 |
TypeError |
顶层不是列表 | 提示学生数据错误后回退 |
ValueError |
学生记录不满足要求 | 提示学生数据错误后回退 |
UnicodeDecodeError |
内容不能按 UTF-8 解码 | 由 ValueError 分支捕获,提示学生数据错误 |
其他 OSError 子类 |
读取权限、文件路径指向目录等 | 提示读取失败后回退 |
把专门异常放在父类异常前面:
1 | |
except 能捕获指定类型及其子类,并采用第一个匹配分支。如果先写父类分支,专门的提示就会被较宽的分支覆盖。参考 JSONDecodeError 说明 和 Python 官方异常层级。
特别记住:UTF-8 读取解码失败并没有漏掉,它进入的是“学生数据错误”分支。
6.6 返回独立的初始数据副本
1 | |
这一步创建新列表,同时浅复制每个学生字典。
| 写法 | 列表是否独立 | 内部学生字典是否独立 |
|---|---|---|
return INITIAL_STUDENTS |
否 | 否 |
return INITIAL_STUDENTS.copy() |
是 | 否 |
return [student.copy() for student in INITIAL_STUDENTS] |
是 | 是 |
不能只因为变量名全大写,就把它当作不可修改的数据;大写只是命名约定。
初始学生当前只有字符串和数字,浅复制字典已经足够。以后加入嵌套列表时,再考虑更深层对象的共享和深复制。
6.7 确认加载与添加的边界差异
| 规则 | 加载文件 | 菜单添加 |
|---|---|---|
| 姓名非空 | 检查 strip() 后是否非空 |
先 strip(),再检查 |
| 去掉保存到内存的姓名首尾空白 | 否 | 是 |
| 检查重名 | 否 | 是,精确比较 |
接受字符串成绩 "80" |
否 | 输入字符串经 float() 转换后可以 |
| 成绩范围 | 0~100 | 0~100 |
| 额外字段 | 保留 | 新建记录只含姓名和成绩 |
在加载函数中写的是 student["name"].strip() 的检查,没有把结果赋回姓名。
所以文件中的 " Tom " 可以加载,却难以用当前菜单查询:的查询输入总会被 strip() 变成 "Tom",不能与原记录精确匹配。
这一小步的检查: 文件缺失时返回初始副本;合法数据返回文件列表;任意一条记录错误时整体回退;[] 保持为空。
七、实现手动保存
7.1 先确定保存的行为
只在选择菜单 6 时保存,将当前完整列表覆盖写入文件。保存成功后提示成功;发生 OSError 时提示失败,列表仍保留在内存中。
1 | |
把成功提示放在 else,只有打开文件、写入并离开 with 块都没有抛出异常时才显示。
7.2 分清保存的三个设置
| 设置 | 用它解决什么问题 |
|---|---|
encoding="utf-8" |
文件文本按 UTF-8 编码写入 |
ensure_ascii=False |
中文等字符通常直接显示,便于阅读 |
indent=4 |
每层缩进四个空格,让 JSON 排版清楚 |
ensure_ascii=False 不负责文件编码,也不会免除必要的引号、反斜线等转义。参数说明见 Python 官方 JSON 写入文档。
7.3 理解为什么使用 w,不使用 a
| 模式 | 行为 | 在这题中的用途 |
|---|---|---|
"r" |
读取已有文件 | 启动加载 |
"w" |
创建文件或截断已有内容,再写入 | 保存完整列表 |
"a" |
在末尾追加文本 | 这版保存不采用 |
如果连续追加多个完整 JSON 列表,会得到 [...][...],它不是单个合法 JSON 文档。因此不能只把 "w" 改成 "a" 来保留多次保存结果。
也记住 "w" 的边界:已有文件一旦成功打开,旧内容就会被截断;写入中途失败时,原文件不一定完整保留。
7.4 明确这版保存能处理哪些错误
这个函数只捕获 OSError。以后如果传入不可 JSON 序列化的对象,TypeError 可能继续向外传播;某些异常字符串导致的 UnicodeEncodeError 也没有在这里处理。
把更可靠的临时文件保存、错误文件备份和补充异常处理放进后面的优化计划,保持当前原始代码不变。
这一小步的检查: 选择保存后,文件能保留中文姓名和正确数据;重新加载时能恢复最后一次成功保存的列表。
八、把功能接入菜单和程序入口
8.1 让菜单负责调度
已经有了各个功能函数,现在需要让它们按照菜单选项被调用。
1 | |
把几个关键位置看清楚:
students = load_students()放在循环外,只在进入菜单前执行一次。while True让菜单持续显示。input().strip()得到去掉首尾空白的选项字符串。match / case将选项分配到对应函数。- 选择
"7"后执行break,结束菜单循环。 case _处理其余输入,然后继续下一轮循环。
匹配的是字符串 "1",因为 input() 返回字符串。" 1 " 会经过 strip() 变成 "1";"01" 和空输入不会匹配菜单 1。
8.2 区分 return 和 break
| 语句 | 在这个程序中怎样理解 |
|---|---|
功能函数中的 return |
结束当前功能函数,回到菜单调用处 |
加载中的 return students |
结束加载函数,把列表交给菜单 |
菜单中的 break |
结束 while True;这版函数随后执行完毕 |
所以,姓名为空时的 return 不会退出整个程序;它只结束本次添加。
8.3 加入程序入口
1 | |
直接运行脚本时,__name__ 为 "__main__",因此会执行菜单。
把脚本作为模块导入时,不会自动进入菜单循环,但顶层的模块导入、常量和函数定义仍会执行。
8.4 检查完整调用关系
1 | |
这些函数共同操作菜单持有的同一个列表。到这里已经把需求、数据结构、各个功能和菜单连接起来。
九、整合得到最终完整代码
按“导入和常量 → 函数定义 → 程序入口”的顺序合并成下面的脚本。函数定义只要在被调用之前完成即可,所以最终文件中的函数排列可以与的学习实现顺序不同。
下面保留第 130 题完整原始代码,共 167 行;分步学习没有改变这版逻辑、注释或提示文字。可以把这一整段保存为 student_manager.py 运行。
1 | |
十、验证正常流程和边界情况
10.1 先验证一次完整操作
从没有数据文件的练习目录开始,按下面的步骤检查:
| 的操作 | 预期看到的结果 |
|---|---|
| 启动程序 | 提示文件不存在,使用四位初始学生 |
| 选择 1 | 显示 Tom、Jack、Mary、Alice |
| 选择 5 | 平均成绩:85.00分 |
| 添加李明,成绩 88 | 添加成功,内存中有五位学生 |
| 查询李明 | 李明:88分 |
| 再查看平均成绩 | 平均成绩:85.60分 |
| 选择 6 | 保存成功,文件包含五位学生 |
| 选择 7,再重新运行 | 若文件仍有效,读取到五位学生 |
用计算核对平均值:
1 | |
10.2 验证文件读取的边界
在退出程序后修改练习文件,再重新启动。因为加载只在启动时执行一次,运行过程中改文件不会自动刷新内存列表。
| 准备的文件情况 | 预期的启动结果 |
|---|---|
| 文件不存在 | 提示后使用初始副本,不立即创建文件 |
| 文件完全为空 | JSON 格式错误,使用初始副本 |
只有 [,或使用单引号 |
JSON 格式错误,使用初始副本 |
顶层为 {} 或 null |
学生数据错误,使用初始副本 |
内容为 [] |
成功加载空列表 |
| 列表元素不是字典 | 学生数据错误,整份回退 |
| 姓名或成绩缺失 | 学生数据错误,整份回退 |
| 姓名为空、全为空白或不是字符串 | 学生数据错误,整份回退 |
成绩为 "80"、true、null |
学生数据错误,整份回退 |
| 成绩为 0 或 100 | 校验通过 |
| 成绩为 -1、101 或非有限数值 | 学生数据错误,整份回退 |
| 一条合法、一条不合法 | 不保留合法部分,整体回退 |
| 文件中有同名学生 | 能加载,查询和删除只处理第一个匹配项 |
姓名为 " Tom " |
能加载,空白保留,菜单难以匹配 |
| 有额外字段 | 能加载,额外字段保留并可随记录保存 |
| 无法按 UTF-8 解码 | 进入学生数据错误分支后回退 |
| 数据路径指向目录 | 进入读取失败分支后回退 |
尤其要区分:
1 | |
10.3 验证交互输入的边界
| 的输入或操作 | 预期的结果 |
|---|---|
| 添加空姓名或全空格姓名 | 提示姓名不能为空,不再询问成绩 |
添加已有姓名 Tom |
提示重复,不再询问成绩 |
添加 tom,成绩 80 |
允许添加,姓名比较区分大小写 |
添加 李明,成绩 88 |
内存保存姓名 李明,成绩 88.0 |
| 成绩为 0、100、85.5 | 添加成功 |
| 成绩为 abc、空输入、-1、101 | 提示成绩输入错误,列表不变 |
| 成绩为 nan、inf、-inf、1e309 | 无法通过范围校验,列表不变 |
查询初始学生时输入 Tom |
去掉输入空白后,匹配 Tom |
| 查询、删除 Unknown | 提示不存在,列表不变 |
| 查看空列表、计算空列表平均成绩 | 提示暂无学生数据 |
菜单输入 1 |
匹配菜单 1 |
| 菜单输入 8、01、abc 或空输入 | 提示无效选项,继续菜单 |
还记住当前未处理的情况:终端输入结束产生的 EOFError,以及用户中断产生的 KeyboardInterrupt。它们可以作为后续扩展。
10.4 验证保存时机和重新启动
| 的操作顺序 | 重新启动后应当看到什么 |
|---|---|
| 添加后直接退出 | 新增学生没有写入文件 |
| 添加、成功保存、退出 | 文件有效时能恢复新增学生 |
| 成功保存后继续添加,再直接退出 | 只恢复最后一次成功保存的内容 |
| 删除全部学生、保存、退出 | 保持空列表,不恢复四位初始学生 |
| 文件错误,回退后选择保存 | 当前列表尝试覆盖原文件,没有自动备份 |
保存发生 OSError |
内存保留;磁盘文件是否完整需要另行检查 |
不能用“本次能看到学生”来判断“下次能否恢复学生”。判断持久化是否成功,要看是否成功保存,以及重新启动后能否正确加载。
十一、回顾易错点,并安排下一步优化
11.1 提醒自己不要混淆这些概念
| 容易误解的地方 | 应当记住的规则 |
|---|---|
| 添加成功等于保存成功 | 添加只修改内存,菜单 6 才写文件 |
| 退出会自动保存 | 菜单 7 只打印并结束循环 |
| 文件不存在就自动创建 | 启动只返回初始数据,保存时才尝试创建 |
| 空列表会恢复初始学生 | [] 合法,保持没有学生的状态 |
| JSON 能解析就能使用 | 解析后仍要校验结构、字段、类型和范围 |
| 加载会过滤错误学生 | 任一记录无效就整份回退 |
| 加载会去空白和查重 | 这版只检查姓名有效性,没有清理或查重 |
| bool 也是可接受的数字 | 成绩确切类型检查会排除 bool |
| 读取编码错误没处理 | UnicodeDecodeError 被 ValueError 分支捕获 |
| with 能处理所有错误 | with 负责关闭,except 负责捕获 |
| 保存失败时旧文件一定完整 | "w" 可能已经截断或部分写入 |
| :g 只移除 .0 | 它还可能舍入或使用科学计数法 |
| 浅复制会复制所有层级 | 更深层的可变对象仍可能共享 |
| 查询函数返回学生字典 | 这版直接打印,返回 None |
| return 和 break 都退出程序 | 分别结束当前函数和当前循环 |
11.2 先计划做这些小改进
这些是的后续练习方向,没有加入第九节的原始代码。
| 想改进什么 | 准备怎样做 | 需要注意什么 |
|---|---|---|
| 统一校验规则 | 提取姓名、成绩或学生记录校验函数 | 加载、添加、修改采用一致规则 |
| 统一姓名处理 | 加载和添加都按统一规则去空白 | 规范化后再检查重复 |
| 复用查找逻辑 | 让独立查找函数接收姓名,返回记录或 None |
界面函数再负责输入、输出 |
| 修改成绩 | 增加菜单,找到学生后验证新成绩 | 全部验证通过后才修改 |
| 未保存提醒 | 成功修改后标记,成功保存后清除 | 保存失败不能清除标记 |
| 更清楚的错误提示 | 区分转换、范围、编码问题 | 保持错误处理范围明确 |
先决定姓名规则:是否区分大小写?是否允许同名?如果要支持同名学生,就考虑用独立学生编号查询和删除。
未保存提醒也可以保留手动保存:退出时给出选择,由决定是否写入文件。
11.3 提高保存的可靠性
后续按下面的方向尝试:
- 保存前验证完整数据。 新增修改、导入功能后,避免把错误数据写入文件。
- 先写同目录临时文件,再替换目标文件。 在写入并关闭成功后再替换,减少中途失败直接破坏旧文件的机会。
- 给错误原文件保留备份。 回退到初始数据后,在覆盖之前保留恢复途径。
- 补充实际需要的异常处理。 根据序列化、编码、写入和替换操作,决定处理哪些异常。
- 需要严格 JSON 时加入
allow_nan=False。 同时处理它可能产生的ValueError;成绩已经排除非有限数值,但加载保留的额外字段没有相同限制。
不会把临时文件替换理解为任何系统故障下都保证无损;它是减少风险的改进方案。
11.4 在功能变多时再考虑这些问题
- 把输入输出和业务处理分开,方便复用与测试。
- 按唯一编号建立索引,减少逐项扫描列表的查找。
- 需要固定成绩精度时,再设计舍入规则或使用
decimal.Decimal;标准 JSON 编码器不能直接保存Decimal,还需要安排转换。 - 明确终端输入结束、用户中断时如何退出。
- 遇到多人同时修改数据时,再学习数据库和并发控制。
十二、用练习检查是否真正理解
12.1 先独立回答概念题
先写出自己的答案,再与下一节核对。
- 把
students与students.json分别放在哪里?为什么添加后还要保存? - 如何区分
load()、loads()、dump()、dumps()? - 为什么分别设置 UTF-8、
ensure_ascii=False和indent=4? - 为什么对空文件和
[]作出不同处理? - 执行
Path(__file__).with_name("students.json")时,会创建文件吗? - 为什么先捕获
JSONDecodeError,再捕获ValueError? - 遇到 UTF-8 解码失败时,加载函数会进入哪个分支?
- 为什么使用确切类型检查成绩?直接改为
isinstance()有什么影响? - 怎样利用
or的顺序避免危险的字段访问? - 为什么同时复制列表和内部字典?只复制列表有什么区别?
- 在添加中写
return、在菜单中写break,分别结束什么? - 用
:g和:.2f显示成绩时,是否改变了保存的数值?
12.2 预测运行结果
练习 A:检查保存时机
从没有 students.json 开始,依次操作:
1 | |
需要回答:
- 保存前会看到多少平均成绩?
- 重新启动后会看到哪些学生?
- Tom 是否还在?怎样解释这个结果?
练习 B:判断加载校验
分别准备下面四种文件内容,每次重新启动,预测采用文件数据还是初始数据。
1 | |
1 | |
1 | |
1 | |
练习 C:检查姓名规则
准备下面的文件:
1 | |
需要解释:
- 能否通过加载校验?
- 输入
Tom查询时,会看到哪个成绩? - 输入
Tom删除后,还剩哪两条记录? - 为什么难以通过当前菜单匹配第一条姓名?
练习 D:区分显示和实际数值
1 | |
先预测三行输出,再判断变量是否被修改。
12.3 动手做扩展练习
另存练习副本,保留完整原始版本对照,每次先完成一项改动。
| 练习 | 要实现的行为 | 的自测方式 |
|---|---|---|
| 重输成绩 | 非法成绩后继续输入,通过后只添加一次 | 依次输入 abc、101、85,最终只有一条新增记录 |
| 修改成绩 | 找到学生后校验新成绩,通过后才修改 | 原成绩 80,输入 101 后仍为 80;输入 85 后改为 85 |
| 统一姓名 | 加载、添加都去首尾空白,并明确重名处理 | 文件含 " Tom " 和 "Tom" 时按既定策略处理 |
| 复用校验 | 提取校验函数,让不同入口使用一致规则 | 同样的非法值在加载、添加中都被拒绝 |
| 未保存提醒 | 成功修改后标记,成功保存后清除 | 无修改退出不提醒;保存失败不能清除标记 |
| 更可靠地保存 | 写同目录临时文件,成功后替换 | 模拟写入失败,检查旧文件是否仍可读取 |
| 拆分查询 | 新函数接收姓名,返回记录或 None |
查询、删除、修改复用同一查找规则 |
为每项扩展明确保存时机,并在修改列表之前完成校验。
十三、核对答案,并整理复习速查
13.1 的概念题答案要点
| 题号 | 核对的结论 |
|---|---|
| 1 | 列表在内存,JSON 在磁盘;添加没有调用保存函数 |
| 2 | load/dump 处理文件对象,loads/dumps 处理字符串 |
| 3 | 分别负责文件编码、非 ASCII 字符转义方式和输出缩进 |
| 4 | 空文件不能解析;[] 是合法空列表,业务规则也允许 |
| 5 | 不会,只生成数据路径 |
| 6 | JSONDecodeError 是 ValueError 子类,先放父类会覆盖专门提示 |
| 7 | except (TypeError, ValueError),因为编码解码错误继承自 ValueError |
| 8 | 精确排除 bool;isinstance(True, int) 为真 |
| 9 | 先确认容器和字段类型,再调用方法或比较;失败后短路 |
| 10 | 两层对象都独立;只复制外层列表仍共享内部字典 |
| 11 | return 结束功能函数,break 结束菜单循环 |
| 12 | 只改变显示文本,数值保持原样 |
13.2 的预测题答案
练习 A:
- 添加 Bob 后,总分为
340 + 100 = 440,人数为 5,所以显示平均成绩:88.00分。 - 保存时,文件中有 Tom、Jack、Mary、Alice、Bob。
- 随后删除 Tom,只修改了内存;直接退出没有再次保存。
- 重新启动后,Tom 仍在,Bob 也在,因为读取的是最后一次成功保存的文件。
练习 B:
true解析为True,类型为bool,会拒绝它并回退。"80"是字符串,会拒绝它并回退。- Jack 的 101 不合法,会整份回退,不会只保留 Tom。
[]能成功加载;查看学生和平均成绩时都会看到“暂无学生数据”。
练习 C:
- 三条记录都满足当前加载校验,能够加载;加载不检查重名,也不改写空白。
- 的查询输入变成
Tom,跳过" Tom ",匹配第二条,输出Tom:90分。 - 删除后,留下
{"name": " Tom ", "score": 80}和{"name": "Tom", "score": 95}。 - 输入总会去掉首尾空白,无法用当前输入方式保留与第一条姓名完全相同的文本。
练习 D:
1 | |
前两行是格式化后的显示文本,第三行仍然显示原数值。变量没有被修改。
13.3 写扩展功能时的提醒
- 先验证再修改,保证失败时不改变原数据。
- 让成绩重输循环在成功添加后正确结束。
- 把返回结果与打印结果区分开。
- 先统一姓名,再检查重复。
- 需要清除未保存标记时,让保存函数明确返回成功或失败。
- 设计临时文件保存时,同时考虑写入、关闭、替换和失败处理。
13.4 的一页速查表
| 关键词 | 需要记住什么 |
|---|---|
| 数据模型 | 列表保存学生字典,姓名为字符串,成绩为数字 |
| 读取 | json.load(file) 后继续校验 |
| 保存 | json.dump(..., ensure_ascii=False, indent=4) |
| 路径 | Path(__file__).with_name("students.json") |
| 关闭文件 | with open(...) |
| 校验顺序 | 容器 → 字段类型 → 非空或范围,利用 or 短路 |
| 成绩边界 | 0 <= score <= 100,包含两端 |
| 异常顺序 | 专门异常在前,父类异常在后 |
| 成功分支 | try 正常完成后进入 else |
| 初始副本 | 新列表和每个学生字典的浅复制 |
| 删除 | 删除第一条匹配项后立即 return |
| 空列表 | 提前返回,避免除以零 |
| 平均成绩 | sum(...) / len(students),显示 :.2f |
| 菜单 | 字符串选项、match / case、while True |
| 保存时机 | 只在菜单 6 保存,菜单 7 不自动保存 |
13.5 的复习检查清单
- 能从题目要求推导出数据结构和函数职责。
- 能按开发路线重新写出这个程序,而不只是复制完整代码。
- 能解释内存修改与文件保存的区别。
- 能区分 JSON 语法错误与学生数据错误。
- 知道合法空列表不会恢复初始学生。
- 能逐项解释加载校验及其短路顺序。
- 知道加载时不清理姓名,也不检查重名。
- 能解释布尔成绩为什么被拒绝。
- 能区分复制列表和复制内部字典。
- 能判断异常应当在哪个函数中处理。
- 能用保存后重启和未保存重启验证持久化规则。